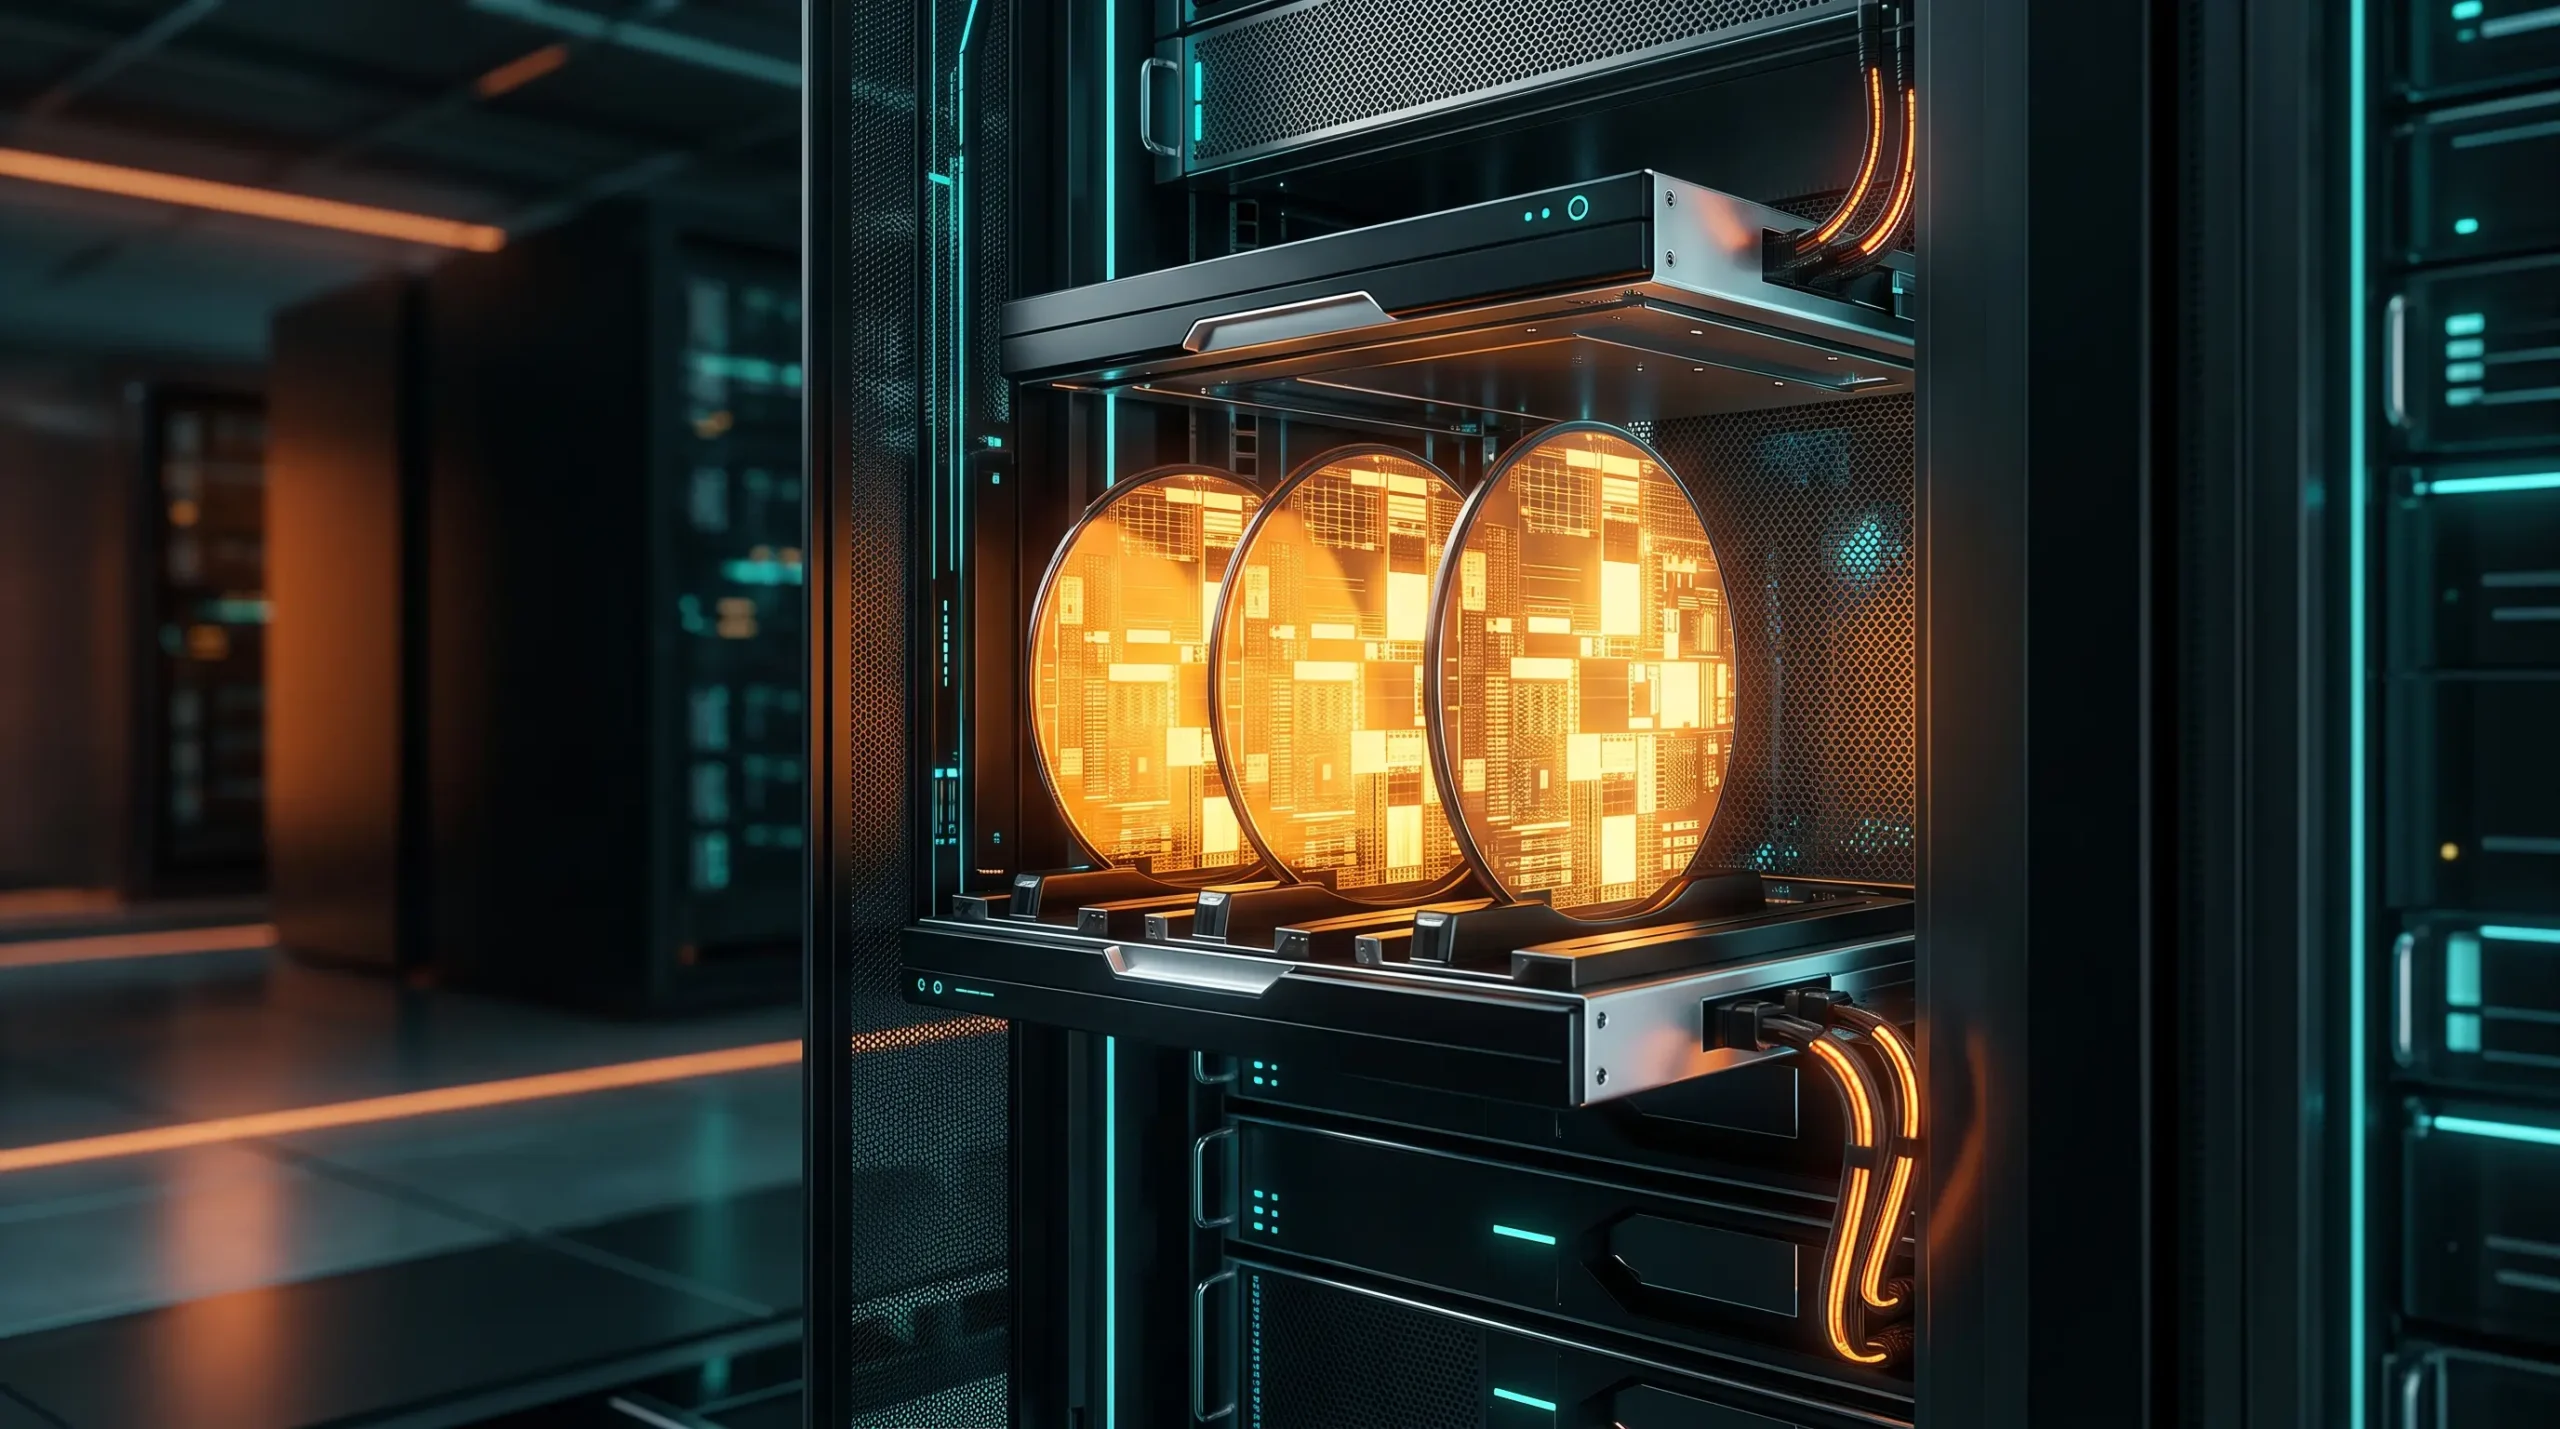
미국 AI 칩 스타트업 세레브라스(Cerebras)가 웨이퍼스케일 엔진 3개를 장착한 4세대 랙스케일 AI 가속기 ‘CS-4’를 정식 공개했다.
세레브라스는 CS-4가 GPU 기반 시스템 대비 사용자당 초당 토큰 기준 최대 30배 빠른 추론 성능을 제공한다고 주장한다. 이는 차세대 ‘랙스케일 컴퓨팅’ 시대의 개막을 알리는 발표로 평가된다.
핵심 성능: 4,400토큰/초의 초고속 추론
CS-4는 3개의 WSE-3 터보(Wafer Scale Engine 3 Turbo) 프로세서를 통합했다. 회사 테스트에서 오픈소스 대형 모델 GPT-OSS-120B를 구동해 사용자당 초당 4,400토큰 이상을 처리했다. 이전 세대 CS-3 대비 최대 2배 빠르며, 와트당 처리량도 최대 10배 향상됐다.
Nexus 랙 아키텍처: 부품 수 50% 감소
CS-4는 새로운 ‘네서스(Nexus)’ 랙스케일 플랫폼 아키텍처 기반 첫 시스템이다. 연산, 전력 변환, 액체 냉각, 입출력 전자회로를 모듈형 ‘백팩’ 단위로 장착하는 설계로 부품 수를 50% 줄이고 데이터센터 확장 속도를 높였다. 직접 웨이퍼 링크(Direct Wafer Links)로 웨이퍼 간 지연을 최저 2마이크로초까지 낮춰 50조 파라미터 초과 모델을 초당 1,000토큰 이상으로 구동할 수 있다.
배경: 추론 시대의 인프라 경쟁
AI 산업의 무게중심이 학습에서 추론으로 이동하면서 처리 속도와 전력 효율이 칩 경쟁의 핵심으로 떠올랐다. 엔비디아 GPU 독점 구도 속에서 세레브라스는 손바닥 크기의 칩이 아닌 ‘접시만 한 웨이퍼 전체’를 하나의 프로세서로 쓰는 독특한 방식으로 차별화를 추구해 왔다.
전망: GPU 패권 도전 가능할까
CS-4의 첫 출하는 2026년 3분기로 예정돼 있다. 소프트웨어 생태계와 대량 생산 능력에서 앞선 엔비디아를 당장 넘어서긴 어렵다는 게 중론이지만, 초고속 추론을 원하는 데이터센터에 새로운 선택지가 생겼다는 점에서 의미가 크다. 국내 반도체 업계에도 웨이퍼스케일·랙스케일 설계 트렌드가 파급될지 주목된다.
자주 묻는 질문(FAQ)
Q. 세레브라스 CS-4의 성능은 어느 정도인가요?
GPU 시스템 대비 사용자당 초당 토큰 기준 최대 30배 빠르다고 주장하며, GPT-OSS-120B 모델에서 초당 4,400토큰 이상을 기록했습니다.
Q. 웨이퍼스케일 엔진이 뭔가요?
칩을 잘라내지 않고 웨이퍼 전체를 하나의 거대한 프로세서로 사용하는 기술입니다. CS-4에는 WSE-3 터보 3개가 들어갑니다.
Q. 출시 일정과 가격은요?
2026년 3분기 첫 출하 예정이며 가격은 아직 공개되지 않았습니다.
Q. 엔비디아와의 경쟁에서 유리한 지점은?
초고속 추론 속도와 와트당 효율(최대 10배)입니다. 다만 소프트웨어 생태계와 생산 규모에서는 아직 열세입니다.
참고: Cerebras 공식 블로그 | Dataconomy | Network World